VPS単体でSNSと同居して運用できる全文検索アーキテクチャ3TSを改良した。単体ユーザ投稿限定および外部公開投稿限定のフィルタに対応し、APIの外部公開時のDoS回避策を導入し、KWICによる検索語ハイライト表示を実装した。
デモ
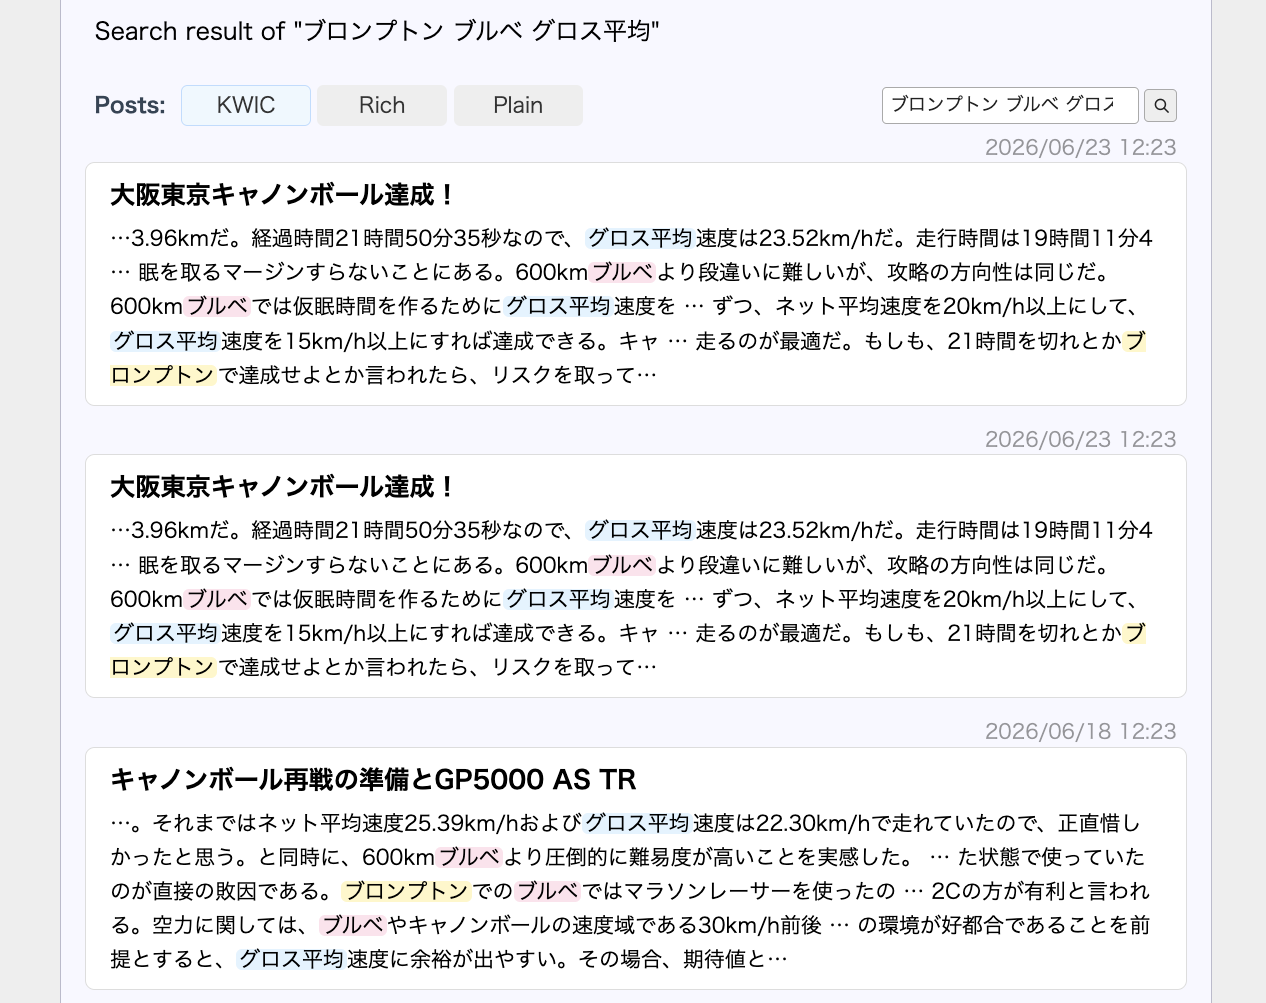
stgy.jpのブログ機能(外部公開記事機能)にて、KWIC付きの全文検索が実装されている。以下のページのプロフィールの下にある検索窓に「ブロンプトン ブルベ」とか「キャノンボール グロス平均速度」とか入れて検索してみてほしい。 stgy.jp
こんな感じで、自分が書いて外部公開した記事のみに限定して全文検索を行った結果の該当記事が表示され、そして記事の本文内のキーワード周辺のフレーズが抽出されて表示される。
単一の検索インデックスで探索空間を分ける処理を高速にするには、そこそこ工夫が必要だ。この記事ではその話をする。また、Google等の検索スニペットと同様に、上述のようなKWIC表示があると便利で、それを実現するための工夫についても述べる。
背景
SQLite FTS5のインデックスを時系列で分割して、新しいインデックスから順番に検索する3TS(Time Tiered Text Search)という全文検索サーバを作って、既に運用している。設計と実装については以下の記事で詳述した。 mikio.hatenablog.com
このアーキテクチャは我ながら賢明なものになっていて、時間計算量も空間計算量も最善に近い。現実的にCPUやメモリにかかる負荷も最低限に抑えている。その努力によって、メモリ4GBの貧乏VPS上でSNS本体と同居させて運用できるようになった。
STGYは実運用を開始していて、現状では私とAIエージェントしかユーザが居ないが、普通に便利に使えている。はてなブログや別の自作CMSで運用していた過去記事をインポートしたことで、ブログエンジンとしてのユーザビリティも実感できるようになってきた。自分の自転車旅日記にAIヒロユキやAIホリエモンが返信してくるし、SNSの片隅でAIサッチャーとAIチョムスキーが労働問題について語り合っているが私ですらそれを読んでいないというのは何ともシュールで終末SFのような状況だが、それが設計意図であり、意外に面白く使えている。
従来から3TSによってSNS上の検索としての基本的要求は満たされていて、検索語を名前や自己紹介に含んだユーザをリスト表示したり、検索語をタイトルや本文に含んだ投稿をリスト表示したりできている。未知のユーザや未知の投稿を探し出すという用途では、SNS全体から該当文書を探して新しい順に提示するという従来の仕様で十分だ。
しかし、記事が増えてくると、自分が既に読んだ特定の記事を探し出すという操作の頻度が増えてくる。新しい記事を書く際には、過去記事と重複や矛盾がある内容を書きたくないので、過去記事の検索を頻繁に行う。別のユーザに返信する際には、そのユーザの過去記事から関連するものを探して文脈を把握してから内容を書くべきだ。知らないユーザにフォローされたら、その人が過去に自分の主たる話題と関連する記事を書いているかどうか知りたくなる。ブログエンジンとして投稿を外部公開するなら、サイドバーに検索窓をつけて、自分が外部公開した記事のみに限定して未ログインユーザにも検索させたくなる。
上述のユースケースを分析すると、以下の機能要件が導かれる。
- SNS内部の投稿検索にて、特定のユーザの投稿のみに対象を絞って検索する
- 外部公開記事の検索にて、特定のユーザの外部公開投稿のみに対象を絞って検索する
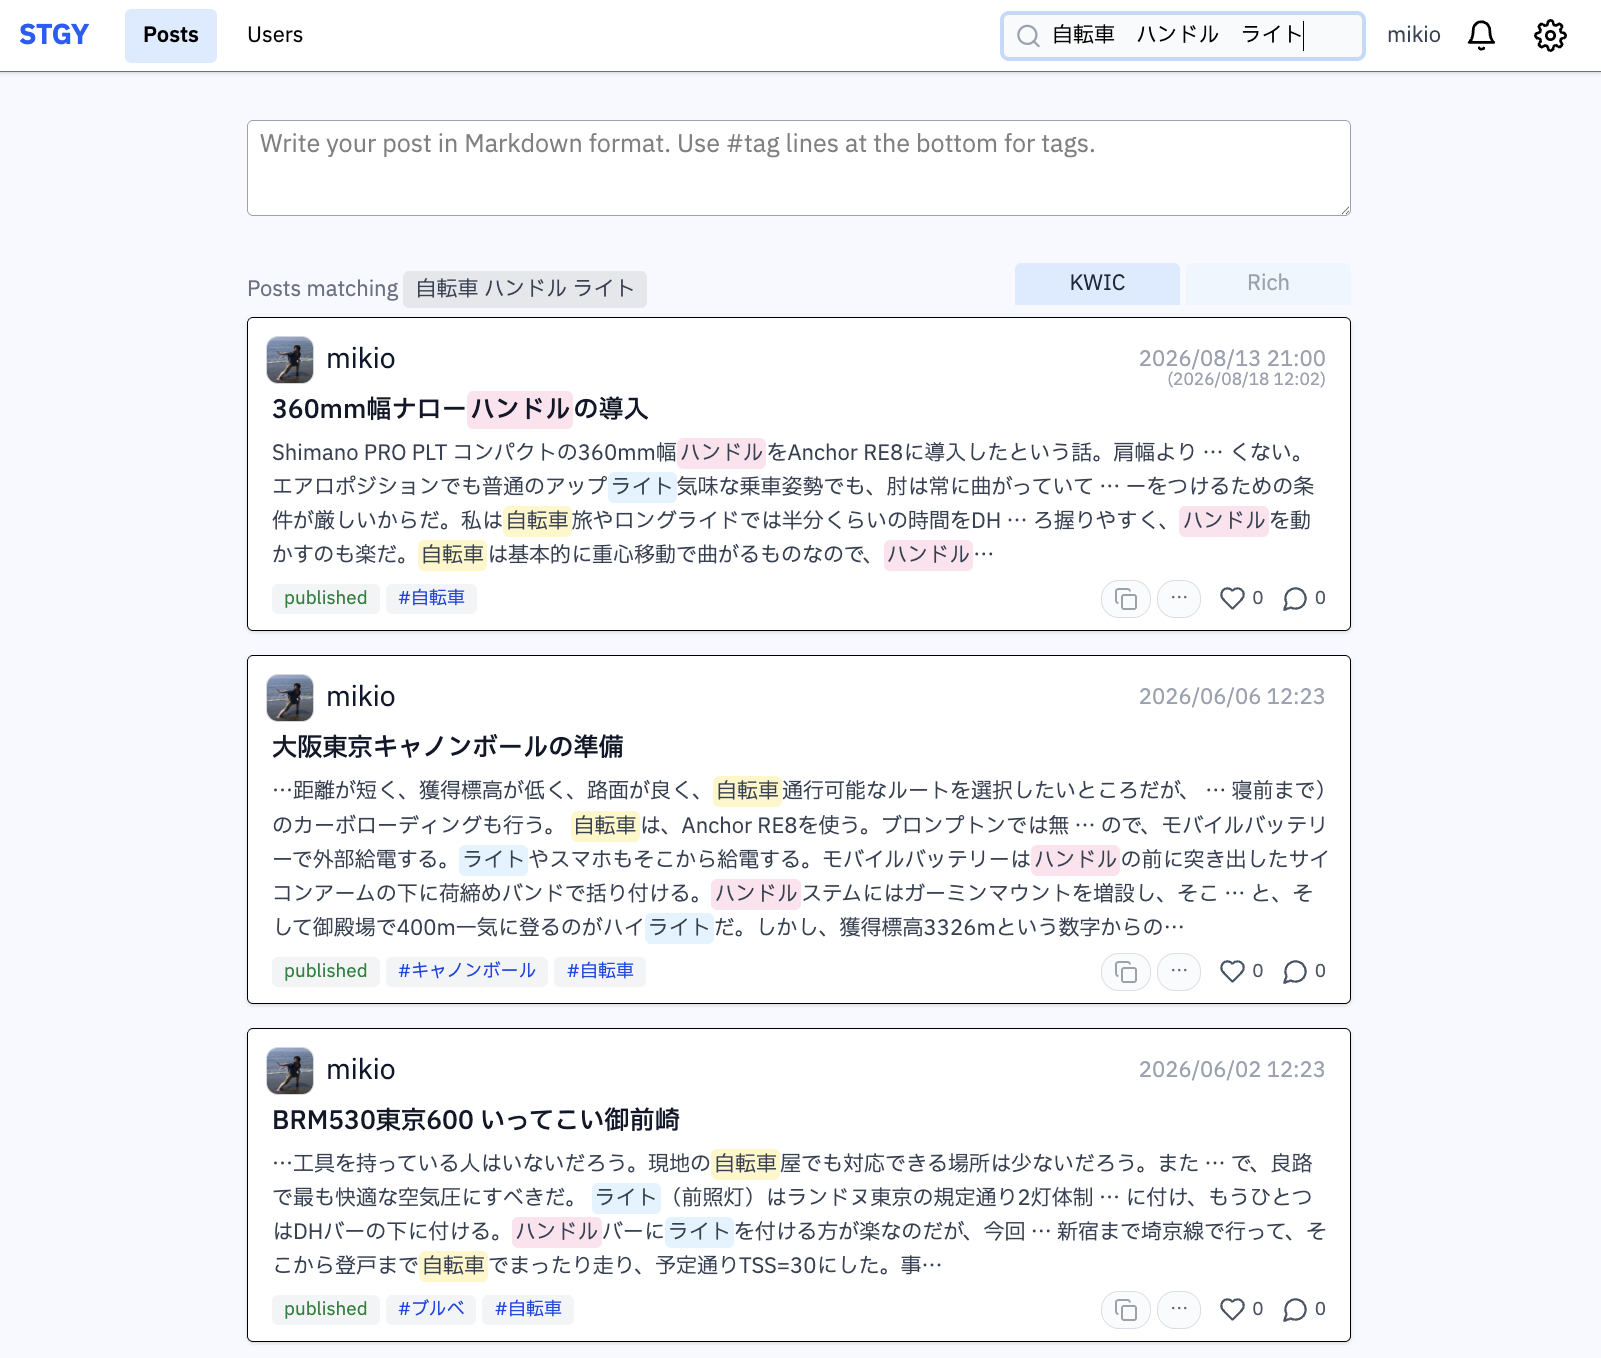
- ユーザ検索および投稿検索の結果において、該当文書の本文中の検索語周辺を抽出したKWIC表示をする
非機能要件としては、検索処理にかかる計算量を悪化させずに対数的にスケールさせることと、外部公開APIがボット等に叩かれて高負荷にならないことが挙げられる。
3TSはSTGYのサブパッケージではあるが、汎用検索エンジンとして設計および実装されている。したがって、3TSはSTGYの事情を一切知らない。3TSの仕事は、受け取った文書集合のインデックスを作ることと、受け取ったクエリに該当する文書IDのリストを返すことだけだ。文書がユーザプロファイルなのか投稿記事なのか別のものなのかは3TSは知らない。その疎結合状態を保ったまま上述の要件を満たす機能を加えていく必要がある。
ラベルによる絞り込み
各ユーザの投稿に限定した全文検索機能を提供する場合、ユーザ毎に別々のインデックスを作るというのが最も素朴な方法である。しかし、10万ユーザいるとして、10万個のインデックスを持つわけにはいかない。仮にそれができたとしても、ユーザを区別しない検索をする際に10万個のインデックスを調べるのは効率が悪すぎるので、全体のインデックスとユーザ毎のインデックスを両方管理することになる。さすがにそれは無駄が多すぎる。
次に思いつくのは、全体の全文検索インデックスを保持するテーブルに著者のユーザID属性をつける方法だ。概念的には以下のようになる。
| doc_id | content | owner_id |
|---|---|---|
| 10001 | お元気ですか | 105 |
| 10002 | ええ、元気ですよ | 203 |
| 10003 | 近頃、暑いですよね | 105 |
| 10004 | 本当ですね | 203 |
これに対して、「contentが "元気" を含み、かつowner_idが203」という条件でクエリを投げれば、10002という文書IDが返される。しかし、owner_idというSTGY固有の情報を3TS側に持たせるのは嫌だ。
次に思いつくのは、合成トークン(synthetic token)を本文内に混ぜる作戦だ。著者のユーザIDを加工して、本文中には出なさそうなパターンのトークンを作り、それを本文の末尾に足す。概念的には以下のようになる。
| doc_id | content |
|---|---|
| 10001 | お元気ですか。 owner_105 |
| 10002 | ええ、元気ですよ owner_203 |
| 10003 | 近頃、暑いですよね owner_105 |
| 10004 | 本当ですね owner_203 |
これに対して、「contentが "owner_203" と "元気" を含む」という条件でクエリを投げれば、10002という文書IDが返される。単一インデックスでユーザIDによる絞り込みを行う方法として、合成トークン方式は非常に効率が良い。この方法だと、FTS5は単に複数語の交差判定をすることになる。これはストリーム方式であり、ポスティングリストの全体をメモリに読み込まずに処理を進める。各検索語のポスティングリストにイテレータを配置し、最も大きいIDを読み込んだものをリーダーとして、残りのものをフォロワーとして読み飛ばし、リーダーの選定とフォロワーのスキップを繰り返しながら処理を進める。一人のユーザの投稿数はその他のユーザの投稿数の合計よりも圧倒的に少ないのが普通なので、ユーザIDの合成トークンのポスティングリストがリーダーになる頻度が多い。そしてリーダーの密度が小さいとフォロワーの読み飛ばしが効率化する。
最初は合成トークン方式を採用しようとしたのだが、いろいろ考えてやめた。合成トークンが本文中に出てこないことを保証できないし、contentを読み込む疑似フレーズ検索の効率も悪くなる。また、contentを返す既存APIの実装も変えなければならないし、ad-hocな制約が入るとメンテナンス性も悪くなる。
FTS5が複数検索語の交差判定をストリーム方式で行うことは既に述べたが、複数の列にまたがる条件についても同様に交差判定できる。ならば合成トークンなど使わずに、ラベル専用のlabels列を設けて、そこにユーザIDを書けばよい。概念的には以下のようになる。
| doc_id | content | labels |
|---|---|---|
| 10001 | お元気ですか。 | owner:105 |
| 10002 | ええ、元気ですよ | owner:203 |
| 10003 | 近頃、暑いですよね | owner:105 |
| 10004 | 本当ですね | owner:203 |
これに対して、「labelsが "owner:203" を含み、かつcontentが "元気" を含む」というクエリを投げれば、同じ結果が得られる。ここで重要なのは、content列とlabels列を同じFTS5テーブルの検索対象列として持つことだ。ユーザID以外にも、「prefecture:saitama」とか「bloodtype:ab」とか、任意の文字列をラベルとして使える。全文検索なので、任意の数のラベル条件を並べてもよい。
同一列の複数語の場合と同様に、複数列にまたがるAND条件でも、どちらかの条件が交差判定のリーダーになる。初回のイテレーションでは最初に書いた方をリーダーとして使う実装になっている。したがって、ポスティングリストが短く選択性能(selectivity)が高いことが強く期待されるユーザIDの条件を先に書くべきだ。この期待はほとんどの場合に真なので、例えば labels:"owner:123" AND tokens:(...) の順にすることで効率的に交差判定できる。とはいえ、リーダーは途中で選定しなおされるので、あんまり気にする必要はない。重要なのは、合成トークンを使う場合もlabels列を分ける場合も、FTS5から見ればポスティングリスト同士をANDで交差させるという基本構造は同じであり、二つの方式でほぼ同等の性能が期待できるということだ。
ユーザIDを条件に加えたからといって、交差判定そのものが非効率になるわけではない。しかし、3TS全体として見ると、ユーザIDで絞り込むことで検索性能が悪化するケースが増える。3TSアーキテクチャの美点は、頻出語の検索では単一インデックスファイル内の交差判定の途中で早期終了するミクロ最適化が働き、さらに分割されたインデックスの一部のみを見て終了するマクロ最適化も働くことで、非常に高速な応答が可能になることだ。稀出語の検索では、各インデックスから読み出すポスティングリストの量が少ないので、分割されたインデックスをすべて調べたとしても、そこそこ高速に応答できる。一方、ヒット数が少ない割に読み出し量が多い「爆弾クエリ」では、インデックスが分割された分だけ遅くなる。そしてユーザIDとの論理積を条件に加えると、検索語単体では大量にヒットするのに指定ユーザとの論理積が極端に疎である、という最悪ケースを踏みやすくなる。
例えば、MATCH labels:"owner:123" AND tokens:(the) はその典型だ。owner:123のユーザが日本語で1000個の投稿をしていて、そのいずれにも「the」は含まれていないとしよう。一方で、「the」は英語のほとんどの投稿に含まれていて、100万件あるとする。この場合、分割された各インデックスで、多くの場合、「owner:123」が支配的にリーダーとなってポスティングリストを逐次進めながら、フォロワーである「the」の巨大なポスティングリストを必要なrowid付近まで飛び飛びにseekして調べることになる。ストリーム方式なのでリーダーのポスティングリストですら一気にメモリへ読み込む必要はなく、フォロワー側も100万要素を先頭から逐次走査する必要はない。しかし最悪の場合、リーダーの1000要素に応じてフォロワー側を1000回程度シークする必要がある。それでも論理積は0件なので、単一インデックス内でも早期終了できず、必要件数が集まらないため3TS全体でも古いインデックスへ検索を続けることになる。ミクロにもマクロにも早期終了が効かないわけだ。
ただし、もともと爆弾クエリだったものについては、ユーザIDが支配的にリーダーとして働くことで逆に性能が改善する場合もある。例えば、MATCH tokens:(the AND を) というクエリでは、「the」も「を」も頻出語なのに両方を含む文書は稀であり、巨大なポスティングリスト同士を交差させる割に結果がなかなか得られない。それを MATCH labels:"owner:123" AND tokens:(the AND を) とすれば、「owner:123」という比較的小さなポスティングリストが起点となり、巨大なフォロワーを効率的にseekできるので、むしろ応答速度が改善する可能性がある。つまりユーザID条件そのものが遅いのではなく、ユーザIDと検索語の論理積の分布によって、3TSの早期終了性は良くも悪くもなる。
この種の非効率性を根本的に回避するなら、ユーザ毎、あるいは複数ユーザ単位でインデックスを水平分割し、最初から物理的な探索空間を小さくすることになる。しかし、それをすると今度はユーザ横断検索の効率やインデックス管理コストが悪化する。STGYでは、ユーザ限定の投稿検索よりもユーザ横断の投稿検索の方が頻繁に行われると考えているので、前者に最適化するための水平分割は今のところ導入しない。現状のlabels方式は、単一の全文検索インデックスを維持したままユーザ単位の絞り込みを行う方式として、十分に効率的だと考えている。
トークナイザの変更
なお、ラベルに任意の文字列を指定できるようにするために、トークナイザの設定も変更した。FTS5では、テーブル毎にトークナイザの設定が変えられるが、列毎には変えられない。ゆえに、本文(tokens列)のトークナイザとラベル(labels列)のトークナイザを同一にする必要がある。本文はロケールに応じた単語毎にトークンを分割したいが、ラベルは付与のリストの個々の要素を一切区切らずにトークンにしたい。そこで、改行でのみ区切るトークナイザをテーブル全体に設定して、データを投入する際に、事前にトークン列を改行で区切った文字列を与えることにした。
トークナイザの具体的な設定は以下のものだ。重要なのは、ホワイトスペース(0x20)文字ですらトークン文字列であることだ。そして、改行(0x0A)とホワイトスペース以外の非印字文字は予め潰しているので、結果的に改行のみがトークンを区切ることになる。
tokenize = "unicode61 categories 'L* N* Co M* P* S*' remove_diacritics 0 tokenchars ' '",
留意すべきは、大文字小文字が区別されないことと、remove_diacriticsによって発音区別符号が除去されることだ。つまり、「Café」と「cafe」は区別されない。ラベルにおいてもそれは同じだ。現状ではラベルには「owner:123456abcde」みたいな文字列しか来ないので問題ない。
合成トークンと列分割の合わせ技
TTTSではポスティングリストを短くするために、detail='none' というオプションをつけている。detail='full' だと、「rowid+列番号+トークン位置」を記録し、detail='column' だと「rowid+列番号」を記録し、detail='none'だと「列番号」のみを記録する。SQLite公式文書によると、fullで743MBのインデックスが、同一文書群でcolumnだと340MBになり、noneだと134MBになる。今回の改修では、tokens列とlabels列を分けることにした。FTS5ではテーブル毎にインデックスを作り、列毎にインデックスを作るわけじゃない。よって、noneでなくcolumnにしないと列の区別ができなくなる。しかし、ラベルを扱うために通常トークンの空間効率が悪化するのは嫌だ。
そこで、ラベルにUnicode私用文字であるU+E000をつけて、「U+E000 + L + ラベル文字列」という合成トークンをlabels列に並べることにした。本文にU+E000は含められないという制限を設けておくと、ラベルの合成トークンが本文中に現れないことが保証されるので、列を区別する必要がなくなる。そうすると、detail='none'でインデックスを作った上で、MATCH演算子で列名を省略できるようになる。MATCH labels:"owner:123" AND tokens:(the) だったクエリは、MATCH "\uE0000Lowner:123" AND (the) となる。
この方法だと、tokens列の末尾に合成トークンを置くのと違って、本文のトークン列を取り出したりフレーズ検索での隣接判定をするのに余計な前処理が要らなくなるし、コードのメンテナンス性も良くなる。それでいて、ポスティングリストの空間効率は以前と全く変わらない。
数値による絞り込み
ラベルによる絞り込みだけでは、外部公開記事の検索にはまだ足りない。STGYでは、あるユーザの記事を検索するとき、そのユーザが書いた記事であるだけでなく、現在時刻以前に公開された記事だけを対象にしなければならない。未来の日付で公開予約されている記事や、まだ公開されていない記事が検索結果から見えてはいけない。
素朴な方法として、一定時間毎に動くワーカーが公開日時になった文書に "published" とかのラベルを付けるというのが思い浮かぶが、それは管理が非常に面倒になるので却下だ。特定時刻に大量の更新が発生するかもしれない。ワーカーが止まるかもしれない。非公開の操作が遅延するのはセキュリティリスクにもなる。よって、あくまで公開日時のタイムスタンプは静的に持たせて、検索にヒットするかどうかを動的に判断するようにしたい。
この条件も3TS側に published_at のようなSTGY固有の属性を持たせれば簡単に実現できる。しかし、owner_idを3TSへ持ち込みたくなかったのと同じ理由で、公開日時というSNS固有の概念も持たせたくない。そこで、文書ごとに一個だけ汎用的な数値属性 numericValue を持てるようにした。STGYではここに公開日時を数値として格納するが、3TS自身はその値が時刻なのか、価格なのか、スコアなのかを知らない。検索時には =, <, <=, >, >= といった単純な数値比較だけを指定できる。
概念的には以下のようになる。
| doc_id | content | labels | numericValue |
|---|---|---|---|
| 10001 | お元気ですか。 | owner:105 | 1787200000000 |
| 10002 | ええ、元気ですよ | owner:203 | 1787201000000 |
| 10003 | 近頃、暑いですよね | owner:105 | 1787300000000 |
| 10004 | 本当ですね | owner:203 | 1787400000000 |
例えば、現在時刻が 1787350000000 であるなら、以下の条件で検索することで、ownerが203で、本文に「元気」を含み、かつ現在時刻以前に公開された文書だけを取得できる。
labels:"owner:203" AND tokens:(元気)
numericValue <= 1787350000000
ここで重要なのは、numericValueによる絞り込みを検索の起点にはしないことだ。例えば numericValue <= now という条件をB-treeインデックスで先に処理することもできるが、ブログ記事の大半は既に公開済みなので、この条件のselectivityは普通かなり低い。全体の99%が published_at <= now を満たすのであれば、そこから検索を始めてもほとんど何も絞れていない。それよりも、まずFTS5で labels:"owner:203" AND tokens:(元気) を処理して候補を絞り、その候補に対して numericValue <= now を確認した方が効率が良い。実際の検索は概念的には以下の順番になる。
- FTS5:
- labels:"owner:203" AND tokens:(元気)
- 候補rowid
- 通常テーブル:
- rowidで1件取得
- numericValue <= now ?
- 条件を満たせば検索結果へ追加
3TSではFTS5の仮想テーブルと通常テーブルを CROSS JOIN し、FTS5側を外側ループに固定している。したがって、SQLiteのクエリプランナが numericValue 側から探索を始めるような実行計画へ変更することはない。FTS5から候補が一件出るたびに、対応する通常テーブルの行を主キーで一点検索し、numericValueを比較する。必要件数が集まれば、その時点で検索を終了できる。
SELECT t.external_id
FROM docs
CROSS JOIN id_tuples AS t
WHERE docs MATCH ?
  AND t.internal_id = docs.rowid
  AND t.numeric_value <= ?
ORDER BY docs.rowid ASC
LIMIT ?;
この方式では、数値条件を追加したことによるコストは、FTS5から何件の候補を調べなければならないかに依存する。最終的にK件の検索結果が欲しく、numericValueの条件を通過する割合を p とすると、候補と数値条件に強い相関がないという単純化のもとでは、調べる候補数Hは概ね、H ≒ K / p となる。例えば10件欲しくて候補の90%が公開済みなら十数件を調べればよいが、10%しか条件を通らなければ100件程度を調べることになる。FTS5から候補が出るたびに通常テーブルを主キー検索すると考えれば、数値判定による追加コストは概ね、O(H log N) である。実際にはSQLiteのINTEGER PRIMARY KEYによるrowid lookupなので非常に軽いが、重要なのはKではなくHに比例するという点だ。
最悪の場合には、FTS5の本文条件とラベル条件に一致した候補をすべて調べても、numericValueの条件を満たす文書が必要件数に達しない。その候補総数をMとすれば、H = M となる。つまりnumericValueはFTS5のポスティングリストそのものを縮めないので、selectivityが極端に高い数値条件では後段判定の負荷が大きくなる。しかし、STGYで主に使う published_at <= now は通常ほとんどの公開記事が通過する条件なので、この方式と相性が良い。
また、数値条件を後段で判定しても、3TSの基本的な早期終了構造は維持される。新しいインデックスから順番に検索し、FTS5から候補を得るたびにnumericValueを確認して、必要件数が集まった時点でそのインデックス内の検索を終了する。最新のインデックスだけで必要件数が得られれば、古いインデックスには触れない。一方、未来の公開予約記事ばかりがFTS5にヒットするような場合には、候補を捨て続けることになるので古いインデックスまで検索が進み、3TSの早期終了性は悪化する。この点はラベルによる絞り込みと同様で、追加条件そのものが高コストなのではなく、追加条件によって最終的なヒットが疎になると早期終了しづらくなることが問題になる。
STGYの外部公開記事検索では、この numericValue <= now と前節のownerラベルを組み合わせている。つまり3TS側では、以下の条件で候補を取得する。
labels:"owner:203" AND tokens:(検索語)
numericValue <= 現在時刻
検索結果として返ってきた文書IDについては、SNS本体のPostgreSQLでもownerと公開日時を再確認する。3TSは高速に候補を絞り込み、PostgreSQLは現在の正しい公開状態を保証する、という役割分担である。このように、ラベルはFTS5のポスティングリスト同士の交差判定に入れて探索空間そのものを縮め、数値条件はFTS5から出てきた候補に対して後段で評価する。両者を同じ種類の属性フィルタとして扱わず、それぞれのselectivityとデータ構造に適した場所で処理することで、STGY固有の概念を3TSへ持ち込まずに、ユーザ単位かつ公開日時を考慮した検索を実現している。
ところで、STGYに置いては、記事を投稿した状態でのデフォルトの外部公開設定は、非公開である。これはユーザの安全を考えてのことだ。ということは、外部投稿記事は、非公開設定(numberValue=null)のまま一度インデックスに登録されて、その後に公開時間を明示的に更新するというのが通常のフローになる。さて、TTTSのレコードの更新エンドポイントでは、UPSERTで行全体を置き換えることしか許していない。レコードの個別の列を更新できるAPIにすると後続処理が組み合わせ問題になって破綻するからだ。しかし、numberValueを更新するだけなら一瞬で終わるのに、tokensやlabelsの全文検索のインデックスまで更新するのは無駄が多い。そこで、TTTS側で、numberValue以外の属性が既存レコードと変わっていない場合にはnumberValueのみを更新するという最適化を入れている。性能最適化は外部仕様ではないというのが重要だ。
性能評価
ここまでで導入したラベルと数値による絞り込みが、実際にどの程度の性能になるのか測定した。前回の3TSの記事とスケール感を合わせるため、100万文書を10個のインデックスに分割して登録する。各文書は英語風の単語を200個含み、語彙数は10000、乱数分布のgammaは0.3とした。各インデックスには10万文書が入る。今回の実行環境はMacBook Air M4、メモリ16GB、macOS 26.6、Node.js 26.5.0である。
ラベルについては1000種類を用意し、各文書にラウンドロビンで一個ずつ割り当てた。したがって各ラベルに該当する文書は全体で1000件、各インデックスには100件ずつ存在する。これは、一人のユーザが1000件の記事を持っている状態をおおまかに模している。numericValueには文書の通し番号を0から999999まで順番に入れた。今回の測定では、位置情報を記録しない recordPositions=false、本文を保存する recordContents=true のデフォルト構成を使っている。
ラベルは本文とは別のFTS5列に格納しているが、予約文字を先頭に付けた合成トークンとして登録する。本文から同じトークンが生成されることはないため、検索時には列を指定せず、本文の語とラベルを一つのMATCH式で論理積にできる。この構成ではポスティングリストに列情報を保存する必要がなく、recordPositions=false ではFTS5の detail=none を使える。つまり、ポスティングリストには基本的に語と文書IDの対応だけを持たせ、フレーズ検索が必要な場合には保存してある正規化済み本文を使って後段で確認する。
100万文書のインデックス生成には221.54秒かかった。約4514文書/秒である。生成テキストは975.96MB、FTSインデックスのpayloadは195.65MBで、生成した本文量の約20%に収まった。本文そのもののpayloadは975.96MB、データベースファイル全体では1389.32MBになった。10万文書ずつの各iterationは21.35秒から22.04秒でほぼ一定しており、インデックスが増えても新しいインデックスを作る負荷は変わっていない。
まず、前回と同じ種類のクエリを、ラベルなしで100回ずつ実行した。limitは100で、表の平均時間はキャッシュに乗った状態での平均である。
| クエリ | 条件 | ヒット数 | 真の該当数 | 初回時間 | 平均時間 | スループット |
|---|---|---|---|---|---|---|
| w0 | 頻出語 | 100 | 999999 | 8.379ms | 0.067ms | 14885.9 QPS |
| w9999 | 稀出語 | 100 | 6021 | 8.547ms | 0.086ms | 11587.4 QPS |
| nohit | 非存在語 | 0 | 0 | 8.521ms | 0.200ms | 4999.8 QPS |
| w0 w1 | 頻出語AND頻出語 | 100 | 946778 | 8.489ms | 0.082ms | 12238.2 QPS |
| w0 w9999 | 頻出語AND稀出語 | 100 | 6021 | 8.499ms | 0.140ms | 7136.5 QPS |
| w8000 w9000 | 稀出語AND稀出語 | 46 | 46 | 9.014ms | 0.507ms | 1972.3 QPS |
| w0 nohit | 頻出語AND非存在語 | 0 | 0 | 8.647ms | 0.217ms | 4604.9 QPS |
測定値はログの通常検索および全件カウント結果による。今回も基本的な3TSの特性は変わっていない。最新インデックスだけで100件を取得できるクエリは0.1ms前後で終わり、全インデックスを調べる稀な条件でも0.5ms程度で済んでいる。detail=none では位置情報だけでなく列情報もポスティングリストから除いているが、通常のAND検索は十分に高速である。
同じクエリに label:203 を追加すると以下のようになった。
| クエリ | 真の該当数 | ラベルなし平均 | ラベルあり平均 | ラベルありスループット |
|---|---|---|---|---|
| w0 | 1000 | 0.067ms | 0.411ms | 2434.5 QPS |
| w9999 | 8 | 0.086ms | 0.358ms | 2792.0 QPS |
| nohit | 0 | 0.200ms | 0.233ms | 4283.7 QPS |
| w0 w1 | 947 | 0.082ms | 0.781ms | 1280.7 QPS |
| w0 w9999 | 8 | 0.140ms | 3.512ms | 284.7 QPS |
| w8000 w9000 | 0 | 0.507ms | 0.463ms | 2159.8 QPS |
| w0 nohit | 0 | 0.217ms | 0.250ms | 3994.6 QPS |
この結果は少し面白い。ラベルを追加すれば必ず速くなるわけではない。例えば w0 は0.067msから0.411msへ約6倍遅くなったし、w0 w9999 は0.140msから3.512msへ約25倍遅くなった。一方、w8000 w9000 は0.507msから0.463msへわずかに速くなっている。
ラベルによってFTS5内部で探索対象を絞れること自体は有利だが、3TSでは新しいインデックスから順に検索し、limit件の結果が集まればそこで終了する。そのため、ラベルを追加した結果として最終的な論理積が疎になると、100件集めるために古いインデックスまで順番に調べることになり、こちらの負荷の方が支配的になることがある。つまり、ミクロなポスティングリスト交差の効率と、3TSのマクロな早期終了性のどちらが効くかで結果が変わる。
w0 のような超頻出語では、ラベルなしなら最新インデックスのポスティングリストを少し読むだけで100件集まる。一方、label:203 に該当する文書は一つのインデックスに100件しかないため、ラベルとの交差を追加した時点でその利点は小さくなる。それでも0.411ms、約2400QPSなので、実用上は十分に速い。
w0 w9999 のように本文条件自体の論理積が疎な場合はさらに厳しくなる。全体では6021件あるのに label:203 に限定すると8件しか残らないため、全10インデックスを調べる。その結果、平均3.512msまで増えた。それでも約285QPS出ているので、ユーザが検索フォームから手動で利用する用途では問題にならない。
逆に、もともと全インデックスを調べる w8000 w9000 のようなクエリでは、ラベルによって探索対象が小さくなる効果の方が勝ち、わずかではあるが高速化している。つまり、ラベル条件そのものが一律に高コストなのではなく、ラベルを加えた結果として最終的なヒット分布がどう変わるかが重要だということになる。
次にnumericValueの性能を見る。検索語にはほぼ全件にヒットする w0 を用い、numericValueの上限を変えて、新しいインデックスを意図的に空振りさせた。
| 条件 | 新しい側で全件rejectされるインデックス数 | 平均時間 | スループット |
|---|---|---|---|
| numericValue <= 999999 | 0 | 0.077ms | 13010.3 QPS |
| numericValue <= 899999 | 1 | 3.416ms | 292.7 QPS |
| numericValue <= 499999 | 5 | 17.581ms | 56.9 QPS |
| numericValue <= 99999 | 9 | 32.592ms | 30.7 QPS |
まず注目すべきは、数値条件を付けても全件が通過する場合は、0.067msだった通常検索が0.077msになっただけということだ。FTS5から候補が一件出るたびに通常テーブルを主キーで引いてnumericValueを比較する処理は、候補がすぐ採用されて早期終了できる限り、ほとんど無視できる。
一方、新しいインデックスの候補をnumericValueで全て捨てるようにすると、時間はほぼ線形に増えた。1インデックスを空振りすると3.416ms、5個なら17.581ms、9個なら32.592msである。全件通過時の0.077msを差し引くと、空振りしたインデックス一個あたりの追加時間は約3.3msから3.6msでほぼ一定している。
これは実装から予想される挙動そのものだ。numericValueはFTS5のポスティングリストを縮めないため、w0 にヒットした大量の候補を通常テーブルから取得して一個ずつrejectする必要がある。そして100件の有効な結果が集まるまで次のインデックスへ進み続けるので、空振りしたインデックス数にほぼ比例して処理時間が増える。
ただし、STGYで実際に使う条件は published_at <= now である。通常の状態では未来の公開予約記事は全投稿のごく一部であり、ほとんどの候補は通過する。つまり実運用は表の一行目に近く、numericValueを追加したこと自体のコストはほぼ無視できる。後ろ3行は、公開予約記事だけを大量に作るなどして意図的に最悪ケースへ近づけた場合の性能だ。
では、同じnumericValueの条件に label:203 を加えるとどうなるか。
| 新しい側でrejectされるインデックス数 | ラベルなし | ラベルあり | ラベルによる高速化率 |
|---|---|---|---|
| 0 | 0.077ms | 0.413ms | 0.19倍 |
| 1 | 3.416ms | 0.772ms | 4.4倍 |
| 5 | 17.581ms | 2.474ms | 7.1倍 |
| 9 | 32.592ms | 4.210ms | 7.7倍 |
数値条件が全件通過する通常ケースでは、当然ながらラベルを加えた方が遅い。0.077msから0.413msへ増えている。しかし、numericValueで新しいインデックスを空振りするケースでは状況が逆転する。1インデックスを空振りする場合で4.4倍、5インデックスで7.1倍、9インデックスでは7.7倍速くなった。
ラベルなしの場合、各インデックスでは w0 に一致するほぼ10万件の候補を順番にnumericValueでrejectしていく。ラベルありの場合には、FTS5内でまず label:203 に対応する合成トークンとの論理積を取るので、numericValueまで到達する候補は各インデックス100件程度にまで減る。そのため、数値条件による後段判定の負荷を大幅に抑えられる。
実測値から見ると、ラベルなしでは空振り一インデックスあたり約3.3msから3.6ms増えていたのに対し、ラベルありでは約0.36msから0.42msの増加で済んでいる。おおむね一桁の差であり、numericValueによる後段判定が重くなる条件では、FTS5側でラベルを使って候補を減らす効果が大きい。
興味深いのは、理論上は候補数が10万件から100件へ1000分の1になるのに、実行時間は1000倍速くなるわけではないことだ。FTS5の探索、SQLiteのクエリ実行、インデックスを切り替える処理、ポスティングリストのseekなど、候補一件のnumericValue比較以外にも固定費が存在するからである。それでも、意図的に作った厳しい条件で4倍から8倍近い差が出るなら、FTS5側でラベルを絞る意味は十分に大きい。
真の該当数を全件数えるモードでも同じ傾向が確認できた。w0 をラベルなしで全件数えると999999件を走査して365.333msかかったのに対し、label:203 を付けると候補は1000件になり13.918msで終了した。約26倍の高速化である。
また、ラベル付きではnumericValueの上限を変えてヒット数を1000件、900件、500件、100件と減らしても、全件走査時間は13.473msから14.108msの範囲に収まり、ほぼ一定だった。numericValueは後段でヒット数を減らしているだけで、FTS5から通常テーブルへ渡される候補集合は最初からラベルによって1000件程度に限定されていることが実測でも確認できる。
以上の結果から、今回のラベルと数値による絞り込みは、少なくとも100万文書規模では十分実用的だと判断できる。ユーザ限定検索ではヒット分布によって通常検索より数倍から数十倍遅くなる場合があるが、今回最も遅かったラベル付きの通常検索でもキャッシュ上では3.512msである。外部公開検索で通常使う「ownerラベル + published_at <= now」という条件では、候補の大半が公開済みなら0.4ms程度で処理できる。そして、公開日時条件が極端にselectiveになってnumericValueによる後段判定が重くなった場合には、ownerラベルによるFTS5側の絞り込みが大きく効く。
ラベルを通常テーブルの属性として候補取得後に調べるのではなく、予約文字付きの合成トークンとしてFTS5のポスティングリスト交差に参加させた設計は、この点で有効に働いている。また、本文のトークンとラベルのトークンを名前空間上で確実に区別できるようにしたことで、検索時に列を指定する必要もなくなり、位置情報を記録しない構成では detail=none を利用できる。100万文書、約976MBの生成本文に対してFTSインデックスのpayloadが約196MBに収まったことも、低コストな全文検索サービスという目的には重要である。
100万文書を扱っても、通常のユーザ限定検索は数千QPS、かなり意地悪な条件でも数百QPS程度出ている。実際のSTGYではさらにCaddyで匿名検索を1 IPあたり60回/時に制限しているわけで、検索エンジン側の処理能力には何桁もの余裕がある。メモリ4GBの貧乏VPSでSNS本体と同居させるという当初の目的から見ても、十分な性能である。
外部公開サイトの全文検索
ここまでのラベルと数値による絞り込みを組み合わせれば、外部公開記事に限定した全文検索を実現できる。STGYの外部公開サイトはユーザ毎に /sites/[id] というURLを持っているので、例えばユーザ203のサイトで「元気」を検索する場合、3TSには概念的に以下の条件を与える。
labels:"owner:203" AND tokens:(元気)
numericValue <= 現在時刻
owner条件はFTS5内で探索空間をユーザ203の投稿に限定し、公開日時はそこから出てきた候補を後段で落とす。3TS自身は owner や published_at の意味を知らず、単に文字列ラベルと数値条件を処理しているだけなので、STGYとの疎結合も維持できる。
ただし、3TSはあくまで全文検索用の副次インデックスであり、アクセス制御の最終判断を任せるべきではない。例えば投稿を非公開に変更した直後には、PostgreSQL側の更新が完了していても、非同期で更新される3TS側には短時間だけ古い状態が残る可能性がある。そこで3TSから返された文書IDについて、STGYのバックエンドでも改めてownerと公開時刻を確認してからレスポンスを返す。つまり、3TS側で行っている条件判定は、主として検索対象を効率的に絞るためのものである。最終的にその投稿を外部へ見せてよいかどうかは、常にSNS本体のデータベースを正とする。この二重チェックによって、副次インデックスの更新遅延が情報漏洩につながらないようにしている。
外部公開サイトではプロフィールの下に検索フォームを置いた。検索すると /sites/[id]?q=... というURLになり、通常の記事一覧の代わりにそのユーザの公開記事だけを対象とした検索結果を表示する。検索結果では通常の記事一覧で使っているOldest指定は意味を持たせず、新しい順に固定した。後述するKWIC、Rich、Plainの表示方式だけを切り替えられる。
未ログインユーザに検索APIを公開する
外部公開サイトなので、この検索はログインしていないユーザにも使わせたい。ここで問題になるのが、全文検索APIを匿名ユーザから直接呼べるようにすることである。
最初に考えられるのは、Next.jsのSSR中に検索を実行する方法だ。しかし、それでは攻撃者は検索APIの存在を知らなくても、
/sites/203?q=非常に重い検索語
というURLを繰り返し取得するだけでバックエンドの全文検索を動かせてしまう。検索APIを直接隠しても、SSRするページそのものが高コストAPIになってしまうので意味がない。
そこで、外部公開サイトの検索結果だけはCSRにした。/sites/[id]?q=... を普通に取得した時点では検索を実行せず、ページをブラウザでhydrateした後にJavaScriptから検索APIを呼ぶ。
- GET /sites/203?q=元気
- Next.js SSRが検索結果の外枠だけ返す
- ブラウザでhydrate
- JavaScriptが検索APIを呼ぶ
- 3TSで検索
これだけで全てのボットを防げるわけではないが、単純にURLを巡回するだけのクローラや、検索パラメータを総当たりするだけのスクリプトから全文検索処理を切り離せる。JavaScriptまで解釈するボットには突破されるが、その場合は次の層で制限する。
匿名検索APIには X-STGY-QueryHash という独自HTTPヘッダを必須にした。検索リクエストのクエリパラメータを正規化し、その文字列のSHA-1を計算してヘッダへ入れる。正規化では、クエリパラメータを一度デコードしてから再度エンコードし、同じキーが複数ある場合も含めて key=value 単位で辞書順に並べ、それを & で連結する。例えば概念的には、「?c=111&a=222&b=444&b=333」を、「a=222&b=333&b=444&c=111」へ正規化してからhashを計算する。
X-STGY-QueryHash: <SHA-1>
SHA-1を使っているが、これは認証でも署名でもない。秘密鍵は存在せず、JavaScriptを読めば誰でも同じ値を生成できる。目的は、APIのURLだけを拾って機械的に叩くような最も単純なアクセスを安価に排除することだ。ハッシュ値をクエリパラメータではなく独自ヘッダへ入れたことにはもう一つ意味がある。他サイトのJavaScriptからこのAPIを呼び出して独自ヘッダを付けようとすると、ブラウザはCORSのpreflightを行う。STGYのバックエンドでは許可するoriginをSTGY自身に限定しているため、第三者サイトのJavaScriptから一般ユーザのブラウザを踏み台にして検索APIを直接叩くことができない。ただし、攻撃者が自分のサーバから直接HTTPリクエストを送る場合にはCORSなど関係ない。それを防ぐのは別の層の仕事だ。
CORSを設定しても、第三者サイトがSTGY自身のページをiframeとして読み込み、そのiframe内でSTGYの正規JavaScriptを実行させる経路が残る。そこでSTGYのメインサイト全体に以下のヘッダを設定した。
Content-Security-Policy: frame-ancestors 'none'
X-Frame-Options: DENY
STGYには外部サイトへページを埋め込ませる用途がないので、iframeを全面的に禁止しても問題がない。これは一般にはclickjacking対策として使われるものだが、今回の場合には、第三者サイトからSTGY自身のJavaScriptを起動して匿名APIを利用する経路を塞ぐ意味もある。
クエリハッシュやCORSの仕組みを理解して再実装するボットに対しては、それらはほとんど防御にならない。そこで本番環境のCaddyでもレートリミットを行う。外部検索APIと公開KWIC APIについては、同一IPアドレスから、1時間60回までに制限した。ジオコーディングAPIにも同じく60回/時の制限を設けているが、検索とは別集計にしている。また、STGY全体には従来から一般アクセス向けのレートリミットも存在する。
検索フォームを普通に人間が使う場合、1時間に60回という制限へ到達することはまずない。一方、自動的に検索語を生成して全文検索を連打するボットに対してはかなり厳しい。この種の処理はCaddyのような前段で落とした方が、Node.jsや3TSまでリクエストを到達させるより圧倒的に安い。
それでも、同じ100回の検索が同じCPU負荷になるとは限らない。普通の検索なら数ミリ秒で終わる一方、前述した爆弾クエリに近いものは大量のインデックスを調べる可能性がある。そこで、STGYのバックエンドには、単純なリクエスト回数だけでなく、高コスト処理に実際に費やした時間をRedisへ積算して制限する仕組みも入れた。ログインしていないユーザについては共通の匿名ユーザとして扱い、匿名アクセス全体で利用可能な処理時間に上限を設ける。
要約すると、匿名全文検索に対しては、以下の仕組みで多層防御を施している。
- CSR = 単純なURLクローラを全文検索処理から切り離す
- X-STGY-QueryHash = 単純なAPIアクセスを排除
- CORS = 第三者originのJavaScriptからの直接呼び出しを禁止
- frame-ancestors 'none' = 第三者サイトのiframe内でSTGY自身を実行する経路を禁止
- Caddyのレートリミット = IP単位で検索回数を制限
- backendの時間スロットリング = 実際に消費できる処理時間を制限
どれか一つで完璧にボットを判別しようとはしていない。クエリハッシュのように簡単に突破できる仕組みでも、実装コストも実行コストもほぼゼロなら、単純なボットをその段階で落とす意味はある。突破するために必要な手間が上がるにつれて、CaddyやCPU時間制限といったより本質的な制限へ引き継ぐ構造にしている。ここでそれらの詳細を書いているし、OSSなのでコードも見られるわけだから、じっくり取り組めば全てを突破するボットを書くことも可能だ。しかし、それをしたところで野良SNSの負荷が多少上がるだけで攻撃者のコストの方が高いので、消耗戦に勝てる構造になっている。
KWIC
全文検索が正しく動いても、検索結果として記事を丸ごと並べるだけでは使い勝手が悪い。例えば1000文字の記事が20件ヒットしたとしても、検索語がそれぞれの記事のどこに現れるのか分からなければ、目的の記事を探すために結局本文を順番に読まなければならない。一般的な検索エンジンが検索結果に本文の一部分を表示するのはそのためだ。検索語とその周辺文脈を抜き出して表示する方式はKWIC(Keyword In Context)と呼ばれる。STGYでも、投稿検索とユーザ検索の結果をKWIC表示できるようにした。
SNS内部の投稿検索とユーザ検索では、KWIC表示とRich表示を切り替えられる。外部公開記事検索では、KWIC表示とRich表示とPlain表示を切り替えられる。Rich表示はMarkdownやアイキャッチ画像を表示するスニペットで、Plainは文字列だけにしてできるだけ多くの結果を1ページに表示するためのスニペットだ。
FTS5には検索語の位置情報があるので、3TS自身にスニペット生成機能を持たせることも考えられる。しかし今回はそうしなかった。3TSの責務は、検索条件に一致する文書IDを効率的に返すところまでに留めた。KWICは検索結果として実際に画面へ表示する文書だけについて、STGYのバックエンドで原文から生成する。具体的には以下のフローとなる。
- 3TSが検索結果の文書IDを返す
- PostgreSQLが現在ページに表示する原文を返す
- packages/markdownがKWICデータを生成する
- フロントエンドがKWICデータをHTMLに変換する
例えば、検索条件に1000文書が一致していても、現在のページに20件しか表示しないなら、KWICを生成するのはその20件だけでよい。検索インデックス全体についてスニペットを生成したり保存したりする必要はない。
この方式には、3TSの検索インデックスと実際に表示する文章がずれないという利点もある。STGYの記事原文はMarkdownなので、KWIC生成にはSTGYが既に持っているMarkdown parserを使う。検索エンジンへMarkdownの意味を教える必要がなく、リンクや装飾などを取り除いたプレーンテキストを一貫した方法で生成できる。
バックエンドには用途別に以下のエンドポイントを用意した。
- /posts/kwic
- /users/kwic
- /posts/kwic-pub
内部用の投稿KWICとユーザKWICは認証済みユーザのみ利用でき、外部公開用の /posts/kwic-pub は未ログインでも利用できる。ただし公開KWICでは、現在時刻以前に公開されている投稿だけを対象にするため、任意の投稿IDを指定して未公開記事の本文を取得することはできない。
KWIC生成処理は packages/markdown に実装した。投稿の場合、まずMarkdownからタイトルを分離する。タイトルは省略せず全文を表示し、検索語が含まれていればその部分だけをハイライトする。残りのMarkdown本文をプレーンテキスト化し、その中から検索語の周辺だけを抜き出す。
ユーザ検索の場合は、nicknameをタイトル相当、自己紹介Markdownを本文相当として扱う。このため投稿検索とユーザ検索で同じKWIC生成ロジックを再利用できる。本文については、検出した検索語1個の周囲をセグメントとして抜き出す。単一セグメントは、前方40疑似トークン、検索後、後方40疑似トークンで構成される。
単純な文字数ではなく疑似トークンという単位を使うのは、日本語と英語で表示上の長さが大きく違うためだ。STGYのMarkdown処理では以前から、概ねASCII系の文字を1、それ以外を2として数える簡単な長さ尺度を使っている。したがって同じ40疑似トークンでも、日本語では文字数が少なく、英語では多くなり、画面上の幅が極端に違わない程度に調整できる。
複数語検索では、単純に本文の先頭から該当箇所を4個拾うだけでは具合が悪い。例えば、「ブロンプトン ブルベ」という2語で検索した記事に、「ブロンプトン」が100回、「ブルベ」が1回含まれているとする。最初の4ヒットを表示すると、すべて「ブロンプトン」になってしまう可能性がある。それではAND検索として記事がヒットした理由の一つである「ブルベ」がどこにあるのか分からない。
そこで、KWICのセグメントを選ぶ際には、検索語とアンカーの一致回数に制限を持たせる。現在は最大4セグメントなので、2語検索なら一つの検索語を理由として選ばれるセグメントは最大2個程度になる。すなわち、セグメント数をS個、検索語数をK個とした場合、各検索語がアンカーに使われる最大回数はS/Kを整数に切り上げしたものになる。
セグメント抽出のアンカーとして検索語を使う回数には制限があるが、セグメント内で検索語をハイライトする際の回数には制限がない。また、40疑似トークンで機械的に切ると、別の検索語の途中でセグメントが終了することになるので、そうならないようにセグメント区切りを拡張するようにもしている。境界を延長した結果、隣接する二つのセグメントが重なった場合には一つへマージする。そのため、最終的に表示するセグメント同士は重複しない。
今回のKWICの実装では、トークナイザを呼んでいない。よって、トークン境界を無視したハイライトが発生する可能性がある。例えば「京都府」で検索すると「東京都府中市」とハイライトされることがある。トークナイザを呼べばこれに対策することができるが、重いのでやりたくない。そこで、CJK言語のQWICの偽陽性は仕方ないことにして、ラテン文字、ギリシャ文字、キリル文字、あたりのフェニキア系文字と数字の連続だけは単語境界とみなさずに中間一致をキャンセルするという実装にした。よって「pro」で「profile」や「sprocket」や「repro」の一部に一致することはない。大文字小文字は発音記号の無視も実装している。
KWIC生成処理はHTMLを返さない。表示に必要な情報だけを持つASTをJSONとして返す。概念的には以下のような構造になる。
{
  "version": 1,
  "title": [
    {
      "type": "text",
      "text": "キャノンボールにおける"
    },
    {
      "type": "highlight",
      "text": "平均速度",
      "keywordIndex": 1
    }
  ],
  "segments": [
    {
      "type": "segment",
      "startPosition": 120,
      "endPosition": 180,
      "isStart": false,
      "isEnd": false,
      "children": [
        {
          "type": "text",
          "text": "……"
        },
        {
          "type": "highlight",
          "text": "キャノンボール",
          "keywordIndex": 0
        }
      ]
    }
  ]
}
startPosition と endPosition はプレーンテキスト本文中のUnicode code point単位の位置で、endPosition はexclusiveである。contextSizeを数えるpseudo tokenとは別の座標系にしている。表示幅を調整するための単位と、原文上の位置を表す単位を混ぜないためだ。セグメントには isStart と isEnd も持たせる。本文の途中から始まるならHTMLレンダラが前に省略記号を付け、途中で終わるなら後ろにも付ける。
highlightノードには keywordIndex を持たせている。これは色そのものではなく、検索クエリ中の何番目のキーワードに対応するかを表す。1個目は黄色、2個目は赤、3個目は青、4個目は緑をそれぞれパステルカラーにしたものをハイライトの背景色に使う。5個目以降は循環させる。色分けするとかなり見やすくなる。
余談だが、SnatcherやらEstraierやらHyper EstraierやらではC言語でスニペット生成をしていて、今回とほぼ同じアルゴリズムを泥臭くポインタを動かしながら書いていた。それに比べると、JSONで抽象化するなんて大富豪な手法は隔世の感がある。ハイライトをパステルカラーにすると見やすいとか、抽出キーワード前後の文字数は40疑似トークンが最適だとかいった経験則はそれらの開発経験から来ている。
キャッシュ
検索結果とKWICスニペットはRedisのキャッシュに入れておいて、同じクエリが複数回呼ばれた際にキャッシュを再利用することで、検索サーバやDBサーバの呼び出しを省いて負荷低減を図る。検索クエリはロングテールなのでキャッシュヒット率は低い。しかし、バズった時の急激な負荷を回避するにはキャッシュの再利用は必須だ。ヒット率を高めることが目的ではないので、TTLは180秒にする。TTLを短くするなら、文書が追加または更新される旅にキャッシュを削除しなくても、フレッシュネスが一定に保たれる。地震が起きた時には皆が「地震」「緊急地震速報」「震源」「震度」などで検索し始めるが、20分前の結果を出すのでは使い物にならない。かといって30秒毎に更新する負荷は貧弱VPSでは心配だ。よって、とりあえず3分くらいにして様子を見る。3TSサーバが返す検索結果のキャッシュと、DBサーバが返した本文データから作られるKWICスニペットのキャッシュは、別々のレコードとして管理される。
TTTSサーバが返すのは文書IDの配列だ。検索条件の属性全てから決めたハッシュ値をキーにして、結果の100件の文書IDのリストを保持する。これは以前からあった機構だが、キーの選定にキーワードだけではなくユーザIDと公開限定フラグも使うところが変更点だ。重要なのは、公開日時の制限を現在のタイムスタンプで表すのではなく、公開限定か否かの真偽値を使うことだ。現在時刻を使ってしまうと決して再利用されないキャッシュになってしまう。
KWICスニペットの生成処理は、表示対象である20個の文書の本文を取り出すだけなので計算量としてはO(log N)に過ぎないが、文書の本文の全体をDBサーバからバックエンドサーバに転送するので、20件も一気にやるとそれなりに負荷がかかる。よって、KWICスニペットのみをキャッシュすべきだ。ところで、KWICスニペットは文書毎かつキーワードリスト毎に作る必要があるので、キャッシュの構造は主に三つ考えられる。(1)文書IDとキーワードリストのペアをキーにしたレコードに個別のKWICスニペットを持たせるか、(2)文書IDをキーにしたレコードにキーワードリストをキーにしたレコードに連想配列を持たせて各値に個別のKWICスニペットを持たせるか、(3)キーワードリストをキーにしたレコードに連想配列を持たせて各値に個別のKWICスニペットを持たせるかだ。結論としては、三番目の方法を採用する。
検索結果のキャッシュはキーワードだけでなくラベルや外部公開限定フラグも含めた粒度でキャッシュを管理しているが、KWICスニペットのキャッシュはキーワードのみの粒度でキャッシュを管理している。この不一致は意図的だ。KWICスニペットのキャッシュは中身が連想配列で、文書が表示される度に中身を再利用するか新規追加するかされる。ページを進めるほどにその連想配列が太っていくことになる。多くの場合は1ページ目しか表示されないが、稀に検索結果全体を見る場合があるというユースケースを考えると、この方式が最適となる。バックエンドにはページの概念がなく、検索結果のどの文書のKWICスニペットを要求するかはクライアント任せなので、ページ単位ではなく文書ID単位でキャッシュされたKWICスニペットを取得でき、かつMGETやMSETという1回の呼び出しでキャッシュの取得や更新ができることが重要だ。
自動疑似フレーズ検索
3TSではインデックスに語の出現位置を収録しない設定がデフォルトだ。そうするとインデックスではフレーズ内の複数トークンの隣接が確認できないので、埼玉大学で検索しても「埼玉」と「大学」が離れて出てくるものがヒットする。それが嫌な場合、 "埼玉大学" として検索してフレーズ検索を強制することができる。そうすると、SQLiteのデータベース内のcontent列から本文を取り出して隣接判定がなされる。これを擬似フレーズ検索と読んでいる。content列のデータを読み出す分だけ遅くなるが、フレーズ検索がたまにしか行われないなら、総合的なスループットは高く維持できる。
とはいえ、ユーザ数が少ない段階でスループットについて気にしても仕方がない。そこで、検索語が複数トークンに区切られた場合はそれがフレーズだったと自動的にみなして疑似フレーズ検索を発動させる機能をつけた。デフォルトで有効になっている。トークンが区切られた場合に発動するので、日本語で検索した場合はそこそこの確率で発動することになるが、投稿数が100万個以下なら全く問題ない。
遅い疑似フレーズ検索を外部公開記事の検索として不特定ユーザに叩かれたら耐えられるのかと心配になるが、実際には問題ない。ユーザIDとトークンの双方で絞り込んだ結果に対して隣接判定を行うので、対象がかなり限定されるからだ。最悪でも、せいぜい一人のユーザが書いた全記事にgrepをかけるのと同じ負荷に留まる。1万件の記事を書くようなユーザが何人も居たら負荷が問題になるかもしれないが、そこまで成長しているなら3TSサーバ専用マシンを立てて位置情報を持つインデックス設定にしているだろう。
まとめ
当初の3TSは、時系列に分割したFTS5インデックスを新しいものから順番に検索し、必要件数が集まった時点で終了するという単純な全文検索サーバだった。今回、実際にSNSとブログエンジンとして運用する中で、特定ユーザへの絞り込み、公開日時による絞り込み、匿名ユーザ向けの外部検索、KWICという機能が必要になった。
しかし、それらをすべて3TSへ押し込むことはしなかった。3TSには検索機能だけを担わせるとともに、ユーザの絞り込みをラベルの絞り込みに、公開日時の絞り込みを数値の絞り込みに抽象化して、STGYとの疎結合を維持する。外部公開記事での検索機能の実現にあたっては、多層防御でDoS攻撃を抑止する。KWICデータの生成はpackages/markdownに移譲して再利用性を高めている。結局今回も、一つの巨大で万能な検索システムを作るのではなく、単純な部品にそれぞれ得意な仕事だけをさせる設計になった。貧乏VPSで運用するには、そのくらいケチくさい方がちょうどよい。
